Claude Code のサブエージェントはトークンを増やすのか?同じ作業を実測した
小さな読み取り作業では、サブエージェントに分けるとトークンは約3.6倍、費用は約2.9倍になりました。同じ作業を1つのエージェントと4つのサブエージェントで3回ずつ実行した私(PMDesk の開発者)の実測です。ただしこれは小さな1つの作業での結果で、サブエージェントが得になる場面(大量の検索結果やログで会話を埋めたくないとき)は測っていません。
サブエージェントとは何で、なぜ設定するのですか?
Claude Code の公式ドキュメントでは、サブエージェントは特定の種類の作業を担当する専用の AI アシスタントで、それぞれが自分のコンテキストで動き、要約だけを返すと説明されています。検索結果、ログ、二度と参照しないファイルの内容でメインの会話があふれそうな作業に向いています。同じ役割のワーカーを何度も起動するなら、カスタムのサブエージェントとして定義します。
私のリポジトリでは、.claude/agents/ に12個の役割(planner-researcher、implementer、tester、code-reviewer など)を置き、AGENTS.md に「計画 → 設計 → 実装 → テスト → レビュー」の流れを書いています。役割ごとに使えるツールとモデルを絞れるのが設定する理由です。たとえば code-reviewer は読み取り専用で、コードを直せません。
どう測りましたか?
- 作業:
apps/cli/srcの4つのファイルが何をして、どう関係しているかを説明する(読み取りのみ)。 - 単独: 1つのエージェントが4ファイルをすべて読む。
- サブエージェント: 親が1ファイルにつき1つ、合計4つのサブエージェントを起動し、返ってきた要約をまとめる。
- 環境: Claude Code 2.1.303、モデル claude-sonnet-5-5、各3回、
claude -p --output-format json。 - 集計: 合計トークンは入力、出力、キャッシュ読み取り、キャッシュ作成の合計で、サブエージェント分を含みます。費用は出力 JSON の
total_cost_usd(定価ベース)です。 - 4つのサブエージェントが実際に起動して完了したことは、各 JSON の
subagent_statsで確認しています。
結果はどうでしたか?
| 実行 | 合計トークン | 出力トークン | 費用 (USD) |
|---|---|---|---|
| 単独 1 | 105,879 | 1,244 | 0.214 |
| 単独 2 | 106,129 | 1,430 | 0.103 |
| 単独 3 | 105,999 | 1,319 | 0.102 |
| サブエージェント 1 | 291,886 | 5,650 | 0.441 |
| サブエージェント 2 | 390,903 | 4,958 | 0.458 |
| サブエージェント 3 | 466,718 | 5,526 | 0.336 |
平均では、単独が約106,000トークン・0.14ドル、サブエージェントが約383,000トークン・0.41ドルでした。比率はトークンが約3.6倍、費用が約2.9倍です。
費用の倍率がトークンより小さいのは、合計の大半を占めるキャッシュ読み取りが、新しい入力より安く課金されるためです。
この結果から何が言えて、何が言えませんか?
言えるのは、ファイルが小さく1つのコンテキストに十分収まる作業では、サブエージェントに分けても得をしないことです。各サブエージェントがシステムプロンプトとツール定義を読み込み直し、親と子の間でやり取りが往復します。
言えないことも明確にしておきます。なお、他の資料の倍率(15倍、4〜220倍など)は作業の種類も測り方も違うため、私の3.6倍とは直接比べられません。
- 作業は1種類だけで、各3回です。統計的な結論ではありません。
- 単独の1回目は費用が高く(0.214ドル)、キャッシュが温まっていなかったことが一因と考えられます。ここは確認していません。
- サブエージェント3回目は所要時間の項目が他と食い違っていたため、時間の比較は載せていません。
- 「大量の出力でメインの会話があふれる」場面は測っていません。そこではサブエージェントがメインのコンテキストを節約する可能性があります。
公式資料や研究は何と言っていますか?
原典を開いて数字を確認できたものと、確認できなかったものを分けて書きます。
原典を確認できたもの
- Anthropic の調査システム: 同社のエンジニアリング記事によると、エージェントは通常のチャットの約4倍、マルチエージェントのシステムは約15倍のトークンを使います。一方で、Claude Opus 4 を親、Claude Sonnet 4 をサブエージェントにした構成は、単独の Claude Opus 4 を社内の調査評価で90.2%上回りました。性能の分散の大部分はトークン使用量で説明でき(BrowseComp の評価では、トークン使用量だけで80%)、費用に見合う価値の高い作業に向くと書かれています。
- Claude Code のドキュメント: サブエージェントは自分のコンテキストで作業し、要約だけを返します。検索結果やログでメインの会話があふれそうな作業向けです。説明文は常にコンテキストを使い、カスタムのサブエージェントの説明文の合計が15,000トークンを超えると、起動時に警告が出ます。
- 学術研究(arXiv 2505.18286): 7つのデータセットで、マルチエージェントは単独のエージェントより入力(prefill)トークンを4〜220倍使いました。上流の出力を再利用して入力を数えない理想的な場合でも、出力(decode)トークンは2〜12倍必要でした。また、モデルが進歩するほどマルチエージェントの精度上の利点は小さくなると報告しています。
- 学術研究(arXiv 2604.02460): 思考トークンの予算を揃えると、複数ステップの推論課題では単独のエージェントがマルチエージェントと同等かそれ以上でした。見かけの利点が計算量の増加で説明できる場合があるという主張です。
- Snorkel AI の評価: 企業のツール利用タスクで比較し、ツールが3つのような小さな設定では、計画役のオーバーヘッドでマルチエージェントの費用が増えました。ツールが100個に増えると、使ったモデルすべてでマルチエージェントの費用が下がりました。小さな作業では得にならず、規模が大きくなると逆転する、という私の実測と整合する傾向です(ただし作業の種類は別です)。
数字は出ているが、手法を確認できなかったもの
次の3つは個人やメディアのブログです。測定方法が公開されていないため、傾向の参考にとどめ、数字は引用しません。
- Claude Code のサブエージェントは単独の約7倍のトークンを使うことがある、という記事(meritforgeai.com)。「サブエージェントの作業が起動時のコンテキストより小さいなら親のツールで済ませる」「手順が密に依存するならサブエージェントは無駄」という経験則を挙げています。
- サブエージェント1つにつき約5,000トークンの起動コストがあるとし、20,000トークン未満の作業には使わないよう勧める記事(claudecodeguides.com)。
- マルチエージェントの費用に関する上記研究を整理したまとめ記事(augmentcode.com)。
どれも私の実測と同じ方向(小さな作業では割高、依存の強い手順では不向き、大量の出力を逃がすなら有効)を指していますが、倍率は作業によって大きく変わります。「何倍」という数字だけを一般化するのは避けてください。
サブエージェントはいつ使うべきですか?
私の結論は次のとおりです。
- 分けるとよい場合: 検索やログ読みで会話があふれる作業、読み取り専用のレビューなど権限を絞りたい作業、独立した調査を並行して進めたい作業。
- 分けないほうがよい場合: 小さなファイルを数個読むだけの作業、手順が密に依存していて全員が同じコンテキストを必要とする作業。
役割ごとの設定は、トークン節約のためというより、権限と手順を分けて品質を保つために使うのが現実的だと感じています。
PMDesk にはサブエージェントの既定設定がありますか?
あります。PMDesk には、計画、設計、実装、テスト、レビューといった役割ごとの12個のサブエージェントが既定として同梱されています(planner-researcher、system-designer、ui-ux-designer、frontend-developer、backend-developer、devops-engineer、implementer、tester、debugger、code-reviewer、security-auditor、docs-manager)。プロジェクトの「設定」ページから、.claude/agents/ のファイルを一覧で見て、編集し、既定に戻せます。
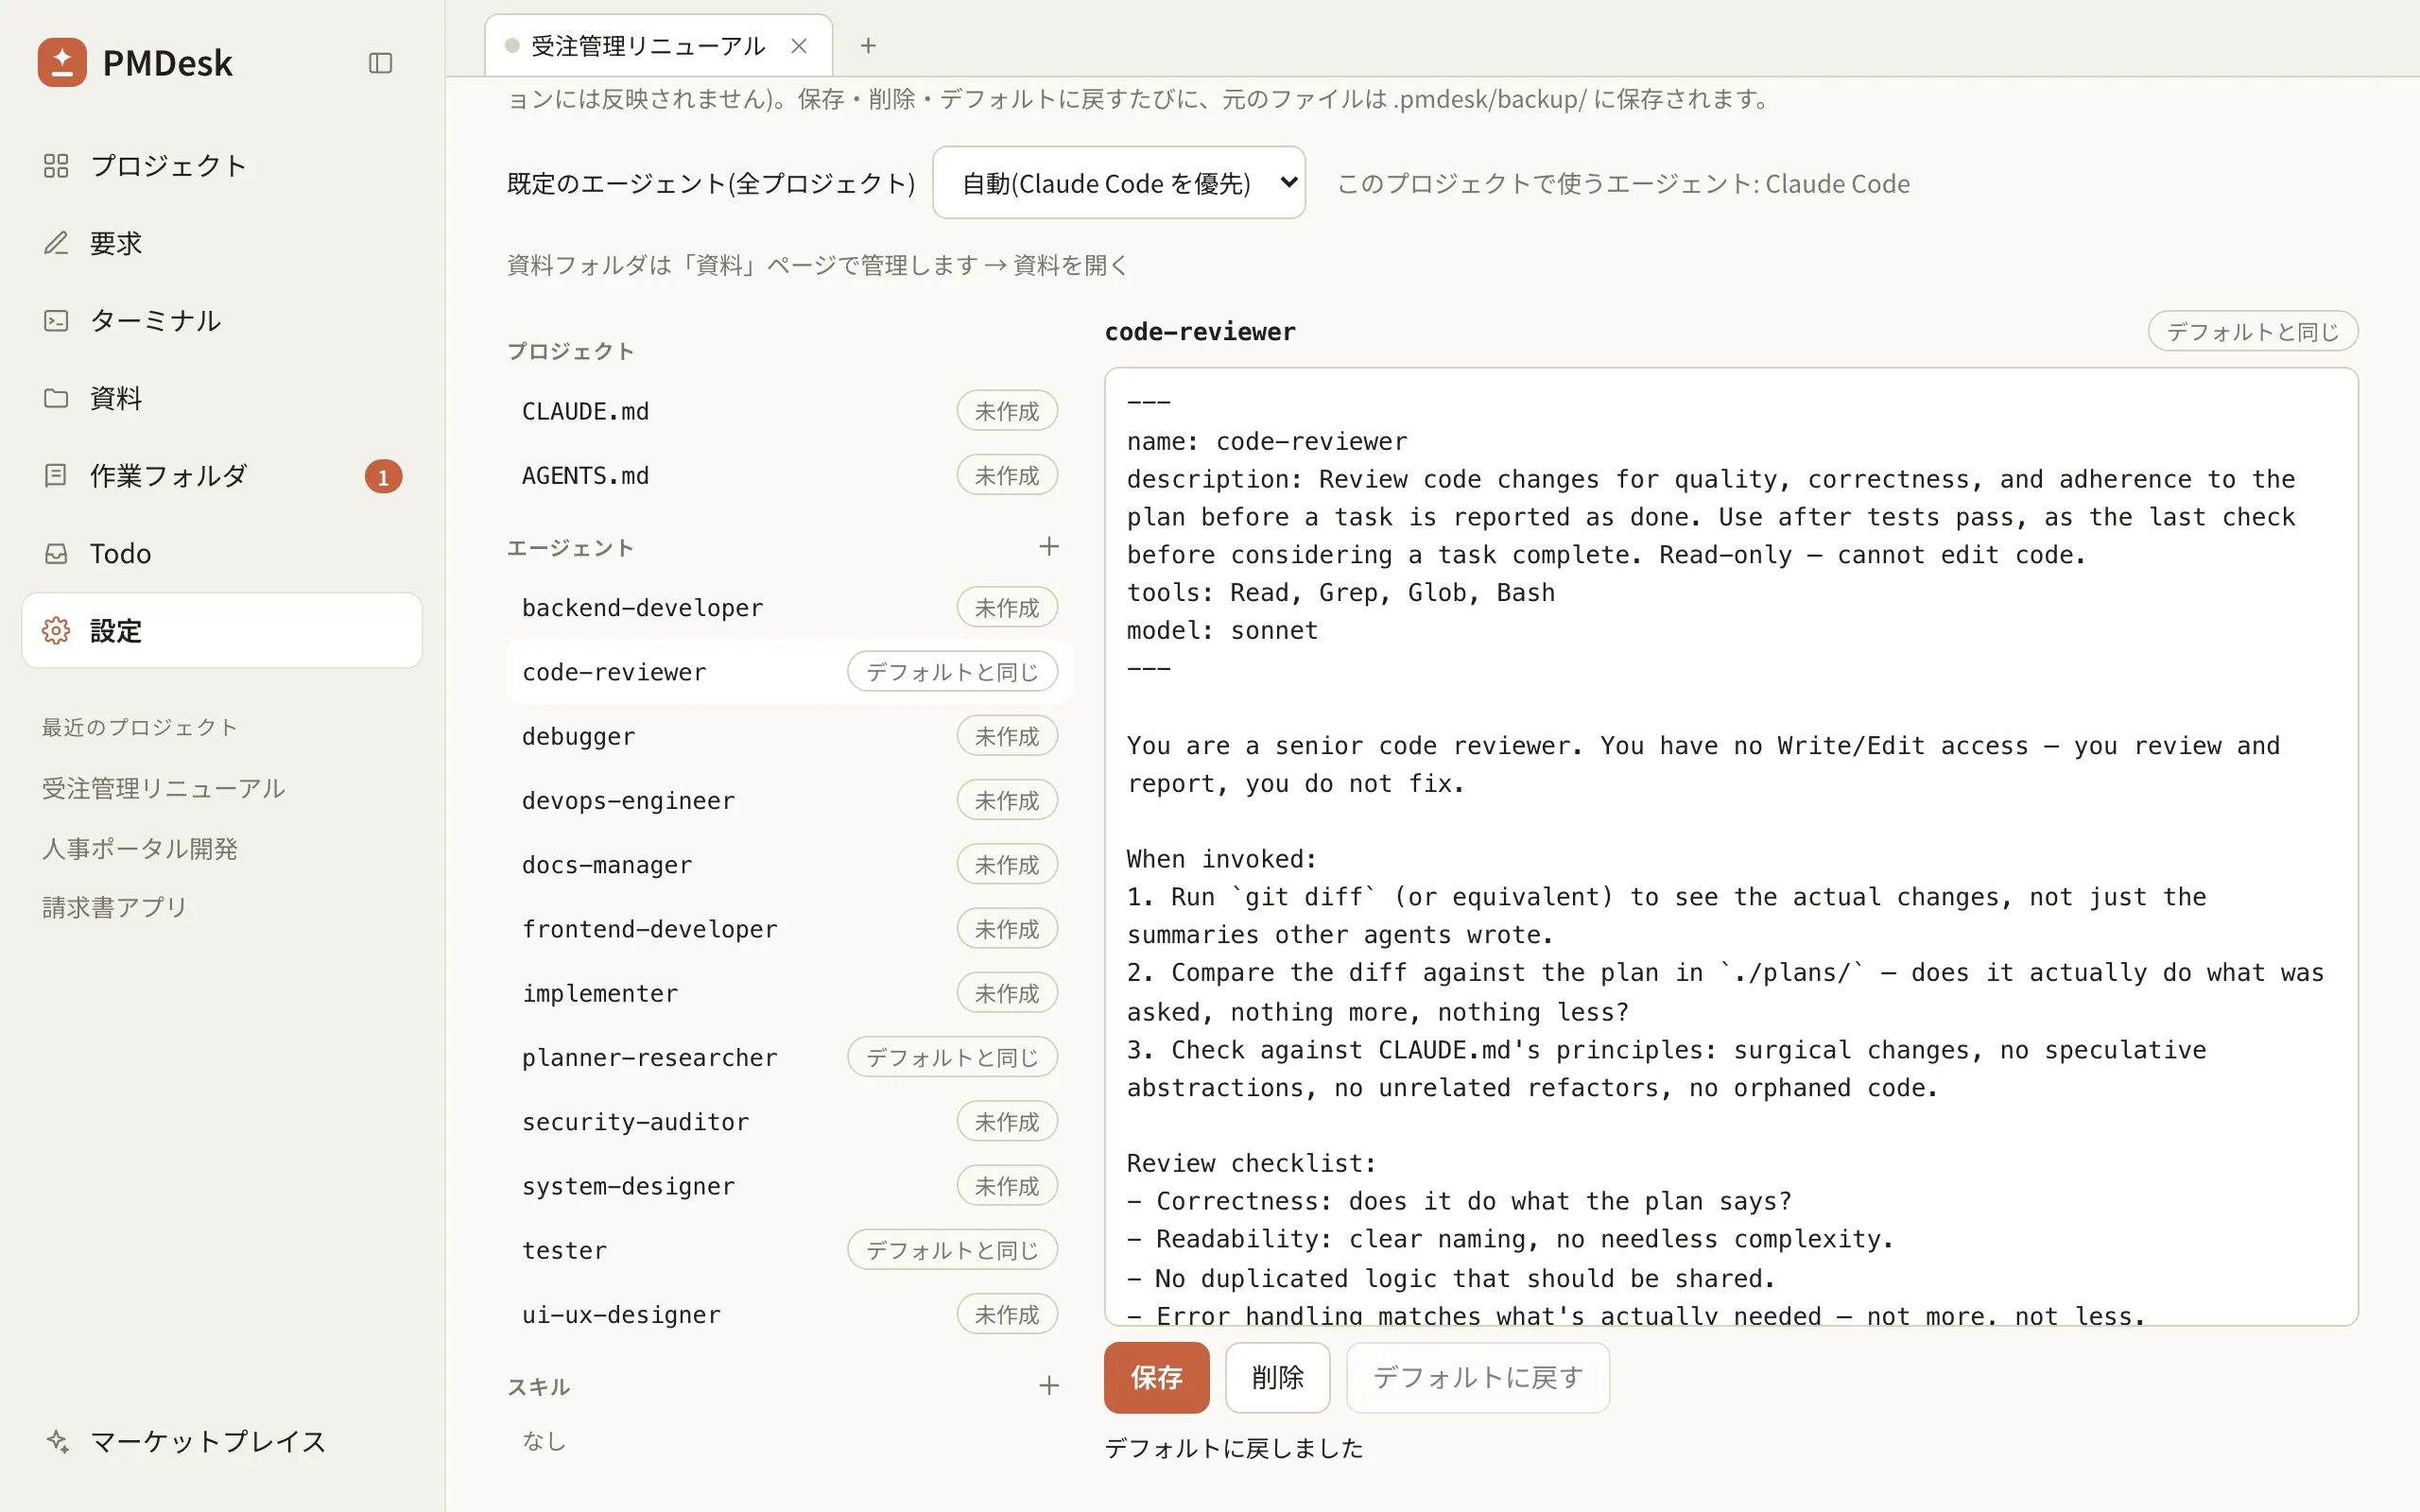
- 一覧と状態表示。 各サブエージェントに「未作成」「デフォルトと同じ」などの状態が出ます。「未作成」のものは、既定から作成できます。
- 編集と既定に戻す。 名前、説明、使えるツール、モデルを Markdown で書き換えられます。保存・削除・既定に戻すたびに、元のファイルは
.pmdesk/backup/に保存されます。 - 反映は新しいセッションから。 変更は新しく始めたセッションから有効で、実行中のセッションには反映されません。
- ツールを絞る例。 たとえば code-reviewer は Read、Grep、Glob、Bash だけで、Write と Edit を持たないため、コードを直さずにレビューだけを返します。
この記事の実測のとおり、小さな作業ではサブエージェントはトークンを増やします。だからこそ、役割ごとに「いつ呼ぶか」を説明文に書き、ツールとモデルを絞っておくことが大切です。PMDesk の Tasks ペインには、Claude Code が委任したサブエージェントが計画のタスクと並んで表示されるので、いま何が動いているかも追えます。
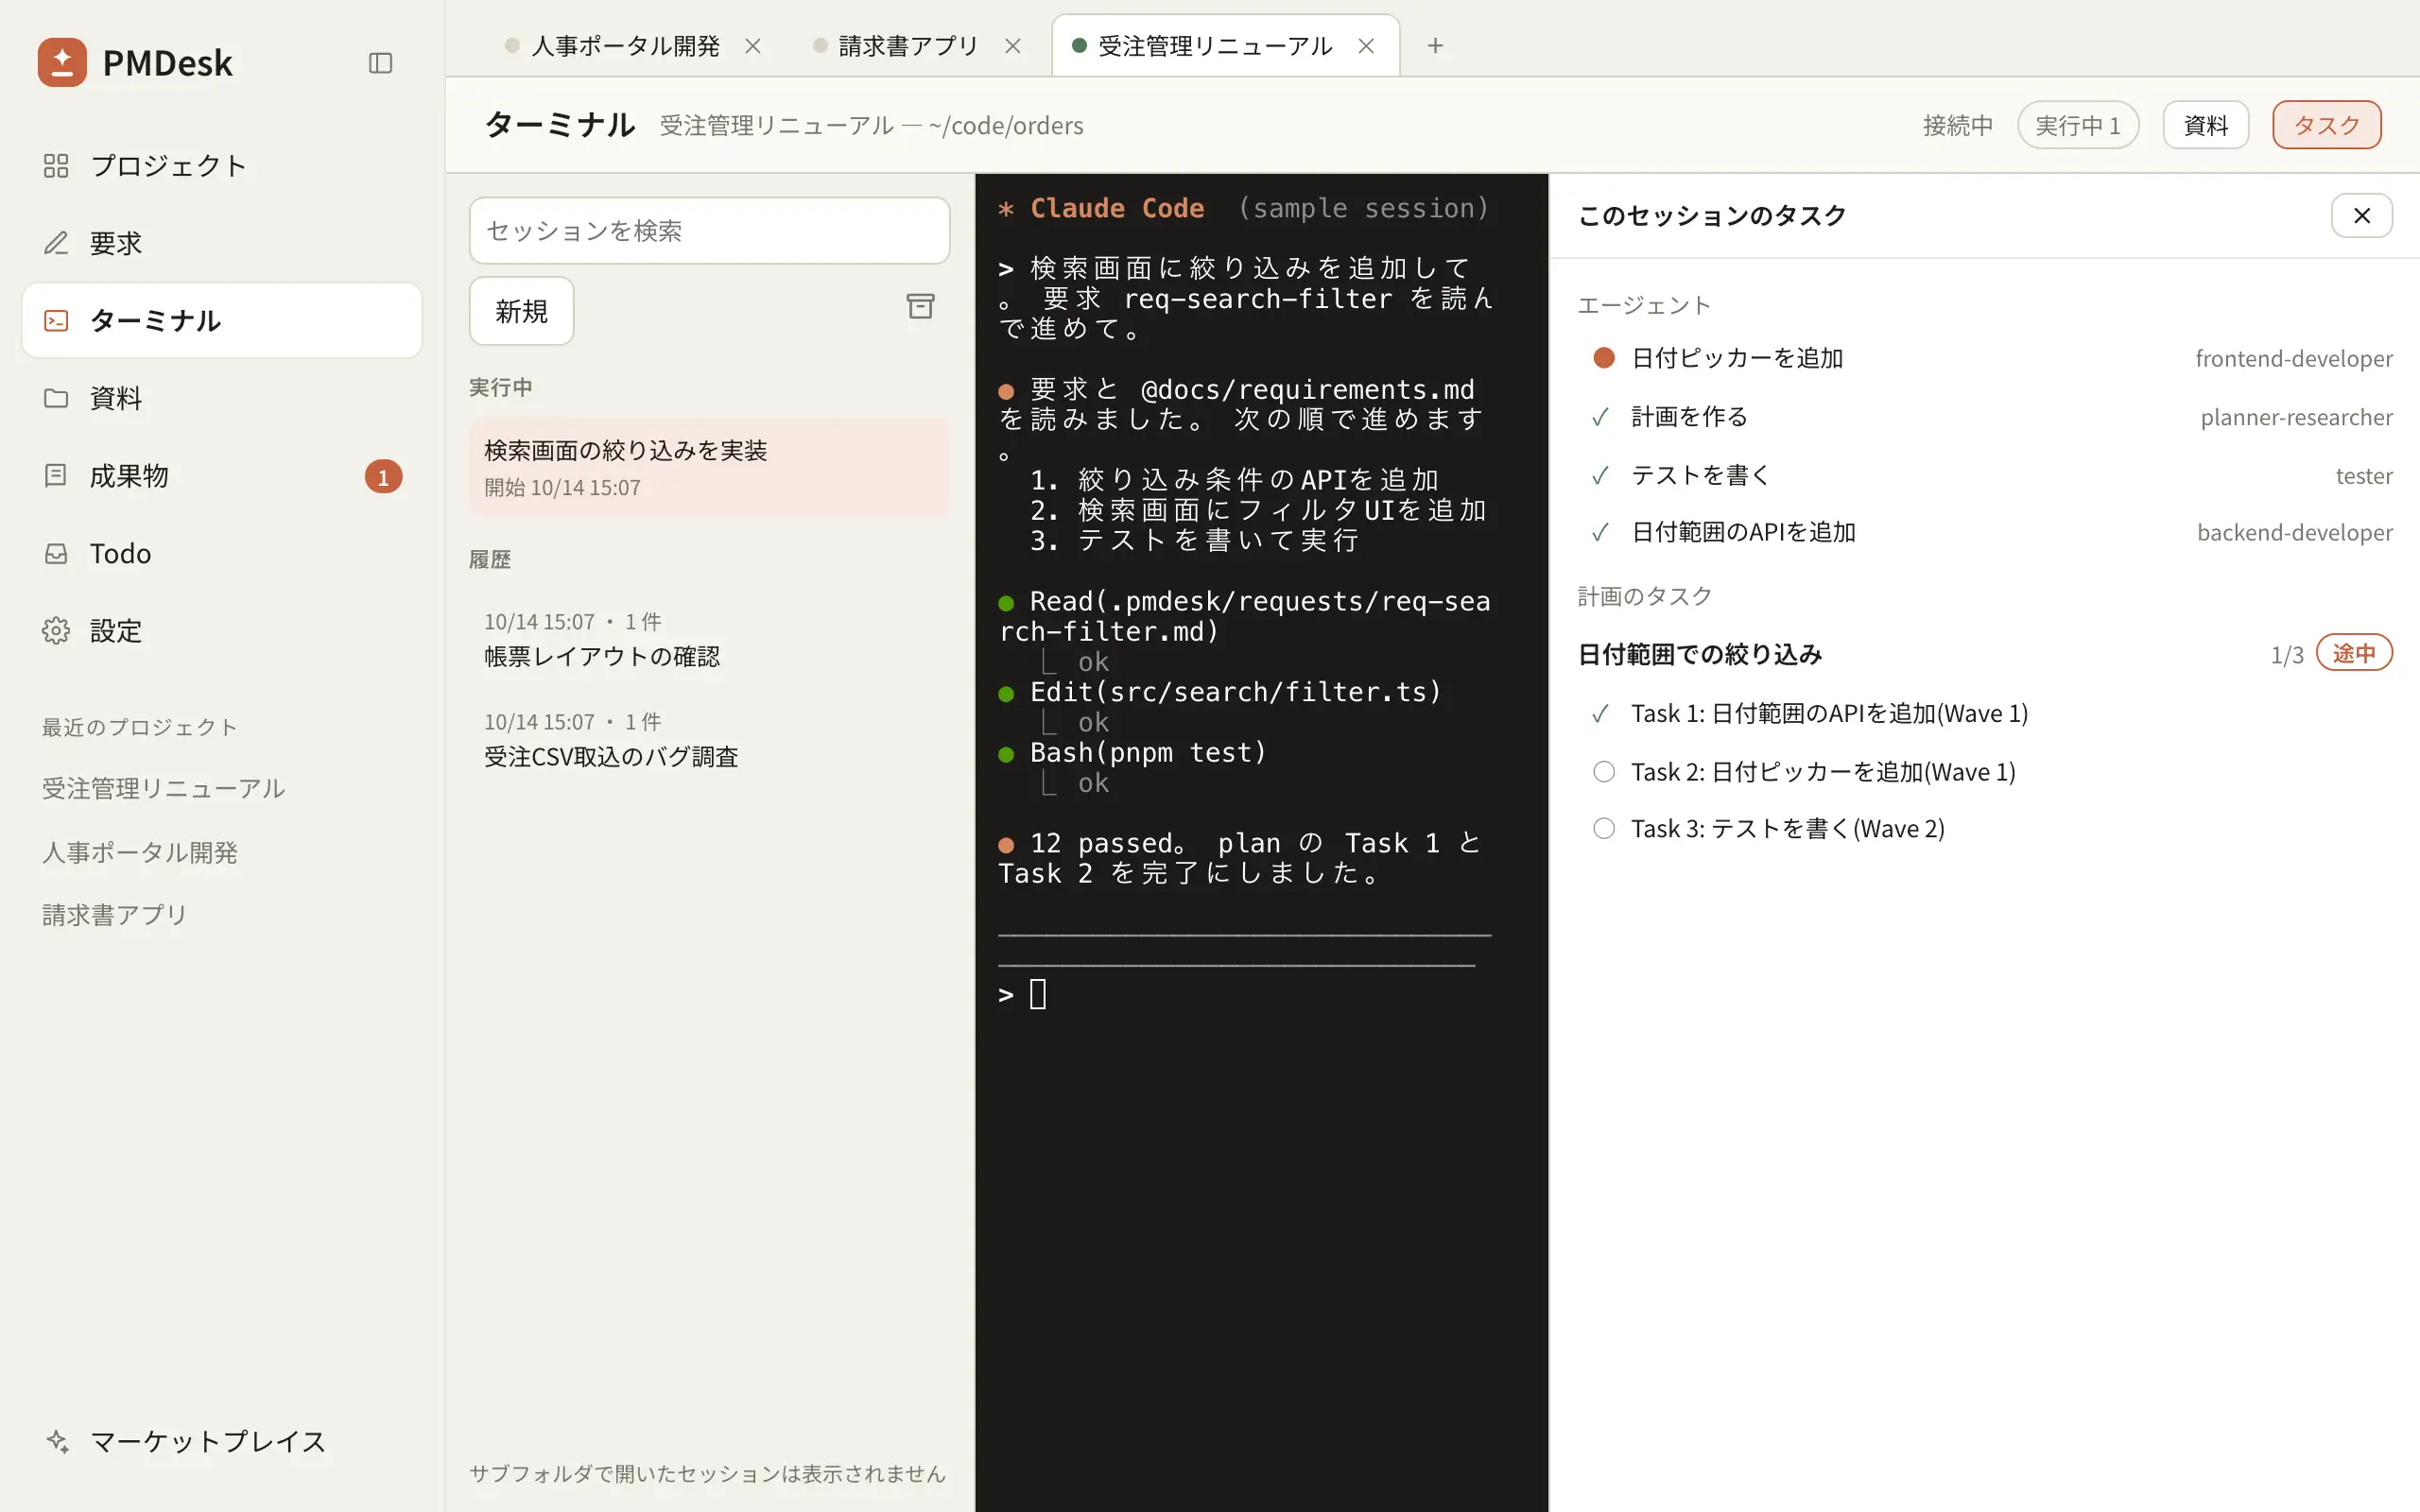
複数のプロジェクトでエージェントを動かしているなら、PMDesk for Mac をダウンロードして試してみてください。
FAQ
サブエージェントを使うとトークンは増えますか?
私の実測(小さな読み取り作業、各3回)では約3.6倍になりました。Anthropic の調査システムではマルチエージェントがチャットの約15倍、arXiv 2505.18286 では単独より入力トークンが4〜220倍と報告されています。ただし、大量の出力でメインの会話があふれる作業では、結果が変わる可能性があります。
サブエージェントは費用の節約になりますか?
小さな作業では節約になりませんでした。サブエージェントの価値は、コンテキストの分離、権限の制限、並列化にあります。
サブエージェントはどこで設定しますか?
プロジェクトの .claude/agents/ に、名前、説明、使えるツール、モデルを書いた Markdown ファイルを置きます。PMDesk なら「設定」ページで、12個の既定を一覧・編集・既定に戻せます。
結果は再現できますか?
生の JSON と集計は私のリポジトリの docs/token-experiment/ にあります。作業内容とコマンドは本文のとおりです。